Fiabiliser ses services d'IA générative : retour d'expérience sur la mise en production d'agents RAG
Chez Athoria, le testing et la qualité font partie de notre ADN. Alors quand nous avons mis en production AIA, notre assistant IA, une question nous a occupés bien avant le moindre incident : comment s'assurer que nos agents restent pertinents le jour où l'on change de modèle de langage, ou simplement lorsqu'on met à jour notre base de connaissances ? Car une application d'IA générative n'a rien de déterministe, et sa base de connaissances est vivante. Sans mesure, sa qualité peut dériver sans qu'on s'en aperçoivent. Beaucoup d'entreprises butent sur la mise en production à grande échelle pour cette raison précise : la difficulté à évaluer et à fiabiliser l'application. Nous aborderons dans cet article notre retour d'expérience sur ce sujet, applicable à toute application d'IA générative textuelle intégrant un RAG.
Les bases d'une architecture RAG
Pour saisir les enjeux de fiabilisation, revenons au fonctionnement d'un agent RAG. Avec un chatbot classique, l'utilisateur interroge une application qui appelle un modèle de langage, mais on reste alors limité aux données d'entraînement du modèle. Ajouter une base vectorielle change la donne : à chaque question, l'application récupère les sections pertinentes de documents, les ajoute en contexte, puis envoie l'ensemble au modèle qui aura alors la capacité de répondre de façon contextualisée et actualisée.
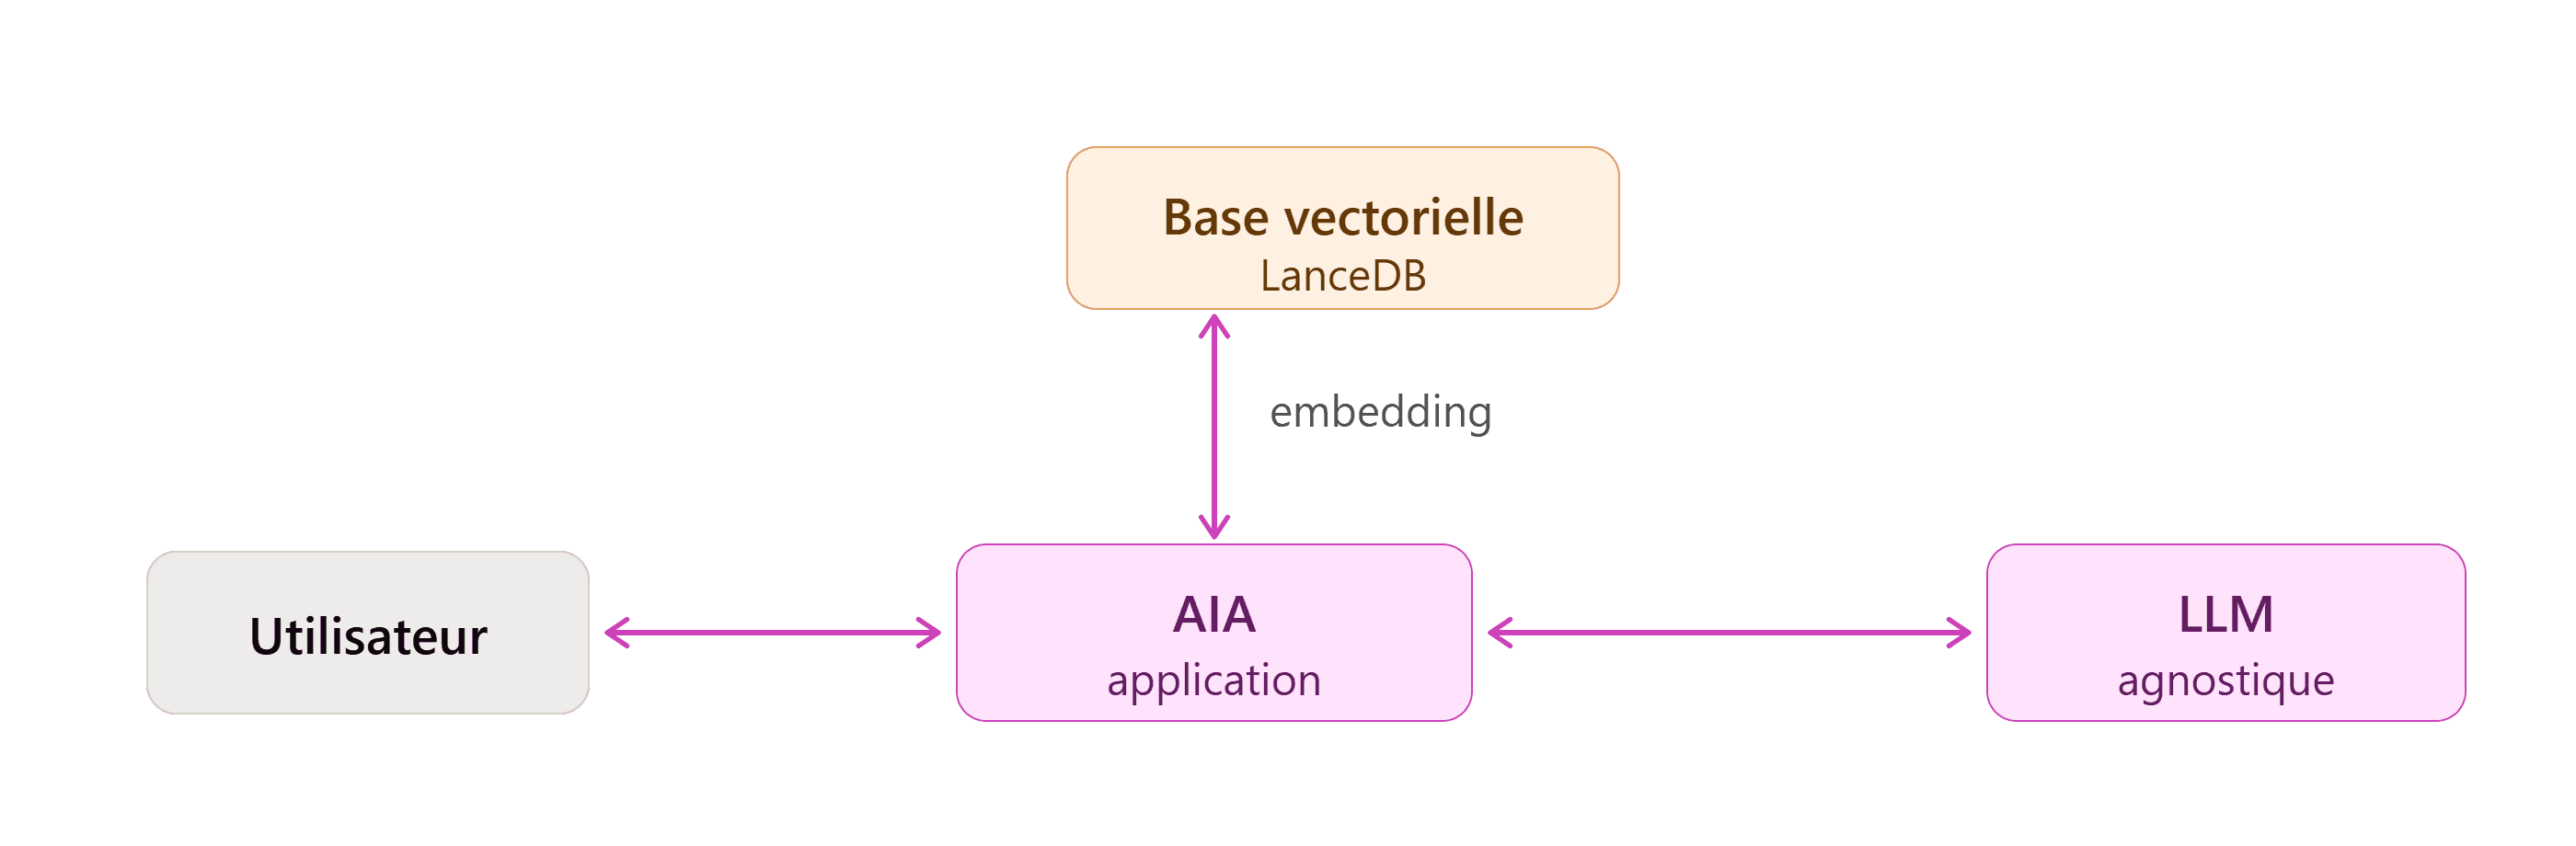 architecture_rag_aia.png
Figure 1 : Schéma général d'une application de type chatbot RAG avec une base vectorielle LanceDB
Le principe est élégant : chaque document est transformé en vecteur par un modèle d'embedding et positionné dans un espace multidimensionnel. La question de l'utilisateur subit la même transformation et se retrouve proche des documents similaires, d'où une construction pertinente du contexte.
Le défi des bases de connaissances vivantes
C'est ici que tout se joue, et c'est ce qui a motivé notre démarche. Contrairement à une application déterministe, un agent RAG évolue avec sa base de connaissances. Dans un monde idéal, cette base ne contiendrait que des documents cohérents entre eux. En pratique, c'est rarement le cas. Au fur et à mesure de son cycle de vie, des documents se contredisent et une mise à jour peut rendre une réponse obsolète. Et sans pouvoir mesurer la pertinence des réponses de notre agent, la qualité risque de se dégrader petit à petit, sans qu'on puisse le percevoir de manière quantifiable.
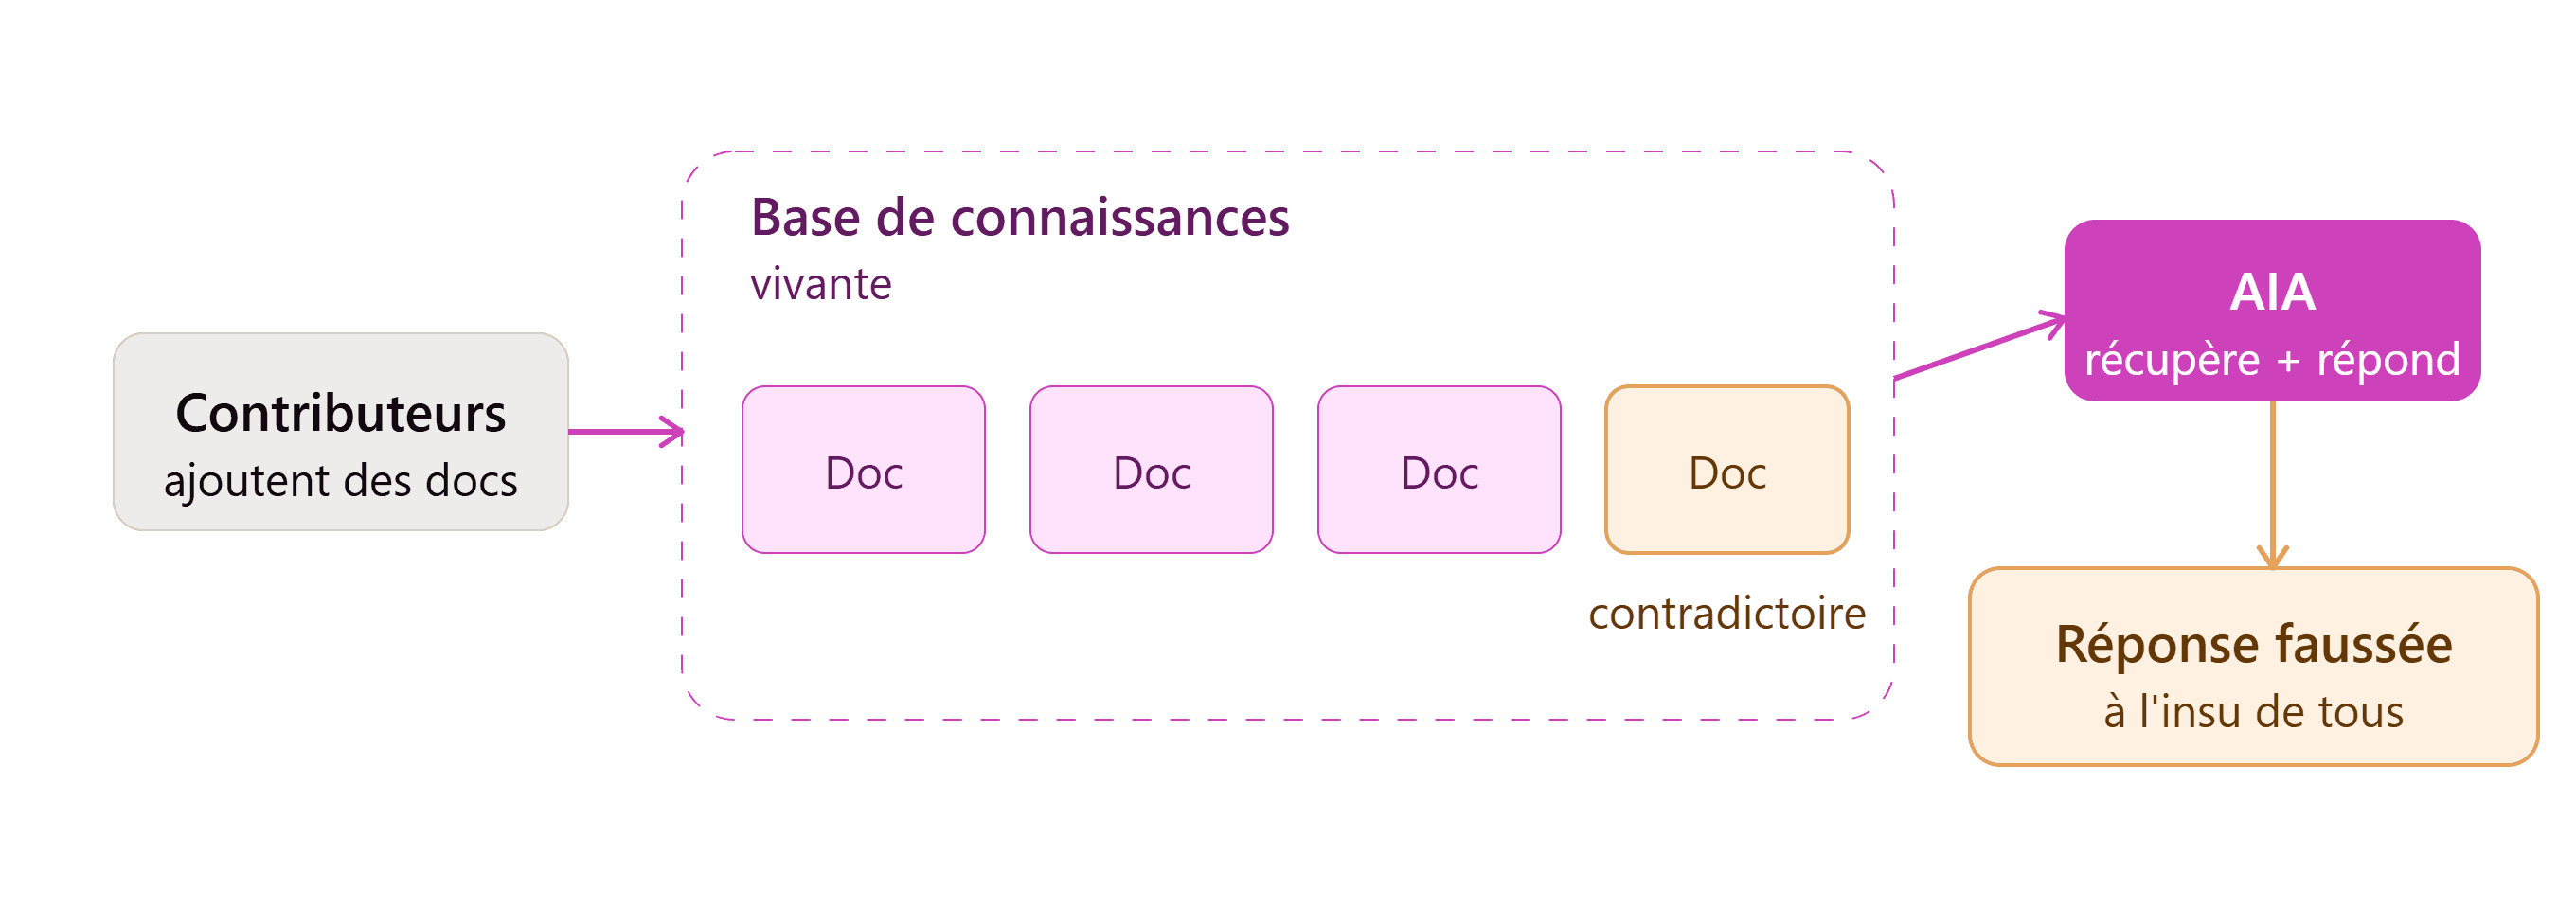 base_vivante_document_contradictoire.png
Figure 2 : Représentation de la problématique d'une base documentaire vivante
Nous n'avons pas attendu un incident pour agir : les problématiques de scalabilité s'anticipent. La problématique est la suivante : comment s'assurer qu'AIA reste pertinent quand on change de modèle, ou qu'on met simplement à jour une procédure documentée ?
Mesurer pour mieux piloter
Comment mesurer alors la qualité des réponses de notre agent ? Plusieurs approches existent, chacune avec ses limites :
| Approche | Avantages | Limites |
|---|---|---|
| Feedback utilisateurs | Naturel, direct | Nécessite des utilisateurs engagés avec une forte connaissance métier et implique une détection tardive |
| Proposer plusieurs réponses | Améliore la qualité du feedback | Alourdit le temps de réponse et la charge cognitive de l'utilisateur |
| Base de questions de référence | Systématique, reproductible | Longue à construire, maintenance continue, annotation manuelle |
La base de questions de référence est l'approche la plus rigoureuse et qualitative d'un point de vue utilisateur final. Mais la problématique reste l'annotation manuelle. C'est exactement là qu'on peut utiliser un modèle pour effectuer cette annotation automatiquement.
L'automatisation de l'évaluation avec "LLM as a Judge"
Le principe est simple : on donne à un modèle la question posée, la réponse générée par AIA et la réponse attendue par un utilisateur expert. On ajoute ensuite des règles exhaustives pour que l'agent puisse donner une note à la réponse . On automatise ainsi notre annotation tout en ayant la capacité de paralléliser l'évaluation afin de pouvoir traiter une grande volumétrie. Un des points clé de notre implémentation est que nous utilisons un SLM (un petit modèle) comme juge, pour garder des coûts maîtrisés à grande échelle. La qualité de l'évaluation reste tout à fait pertinente puisque le contexte est petit et précis. On peut utiliser plusieurs évaluations, avec des instructions différentes, afin de mesurer la qualité de réponse selon plusieurs angles.
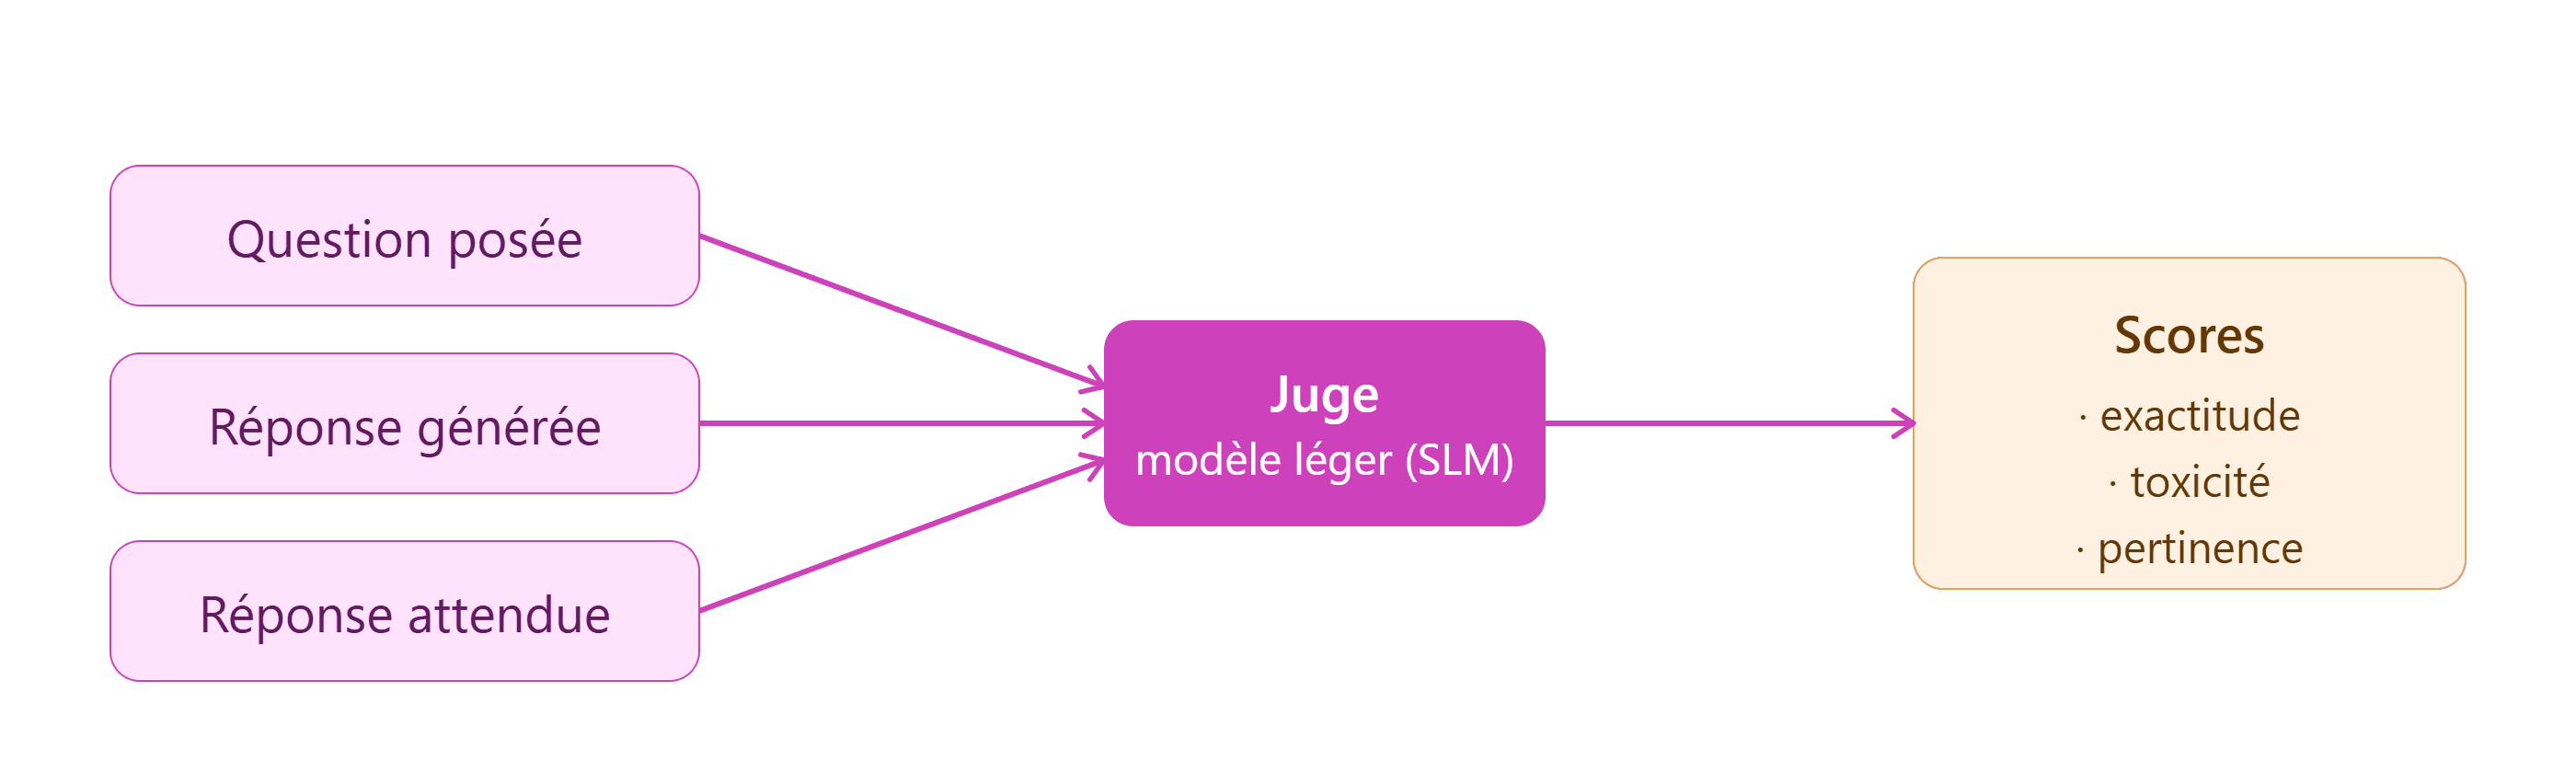 llm_as_a_judge.png
Figure 3 : Représentation du workflow "LLM as a Judge"
Génération automatique de questions
On peut pousser l'automatisation plus loin en générant les questions à partir de la base documentaire : pour chaque document, on demande à un modèle une question pertinente et sa réponse attendue. On sélectionne un ou plusieurs chunks afin d'éviter de générer une question sur tout un contexte trop grand : cela permet de réduire les coûts et une latence supplémentaire inutile.
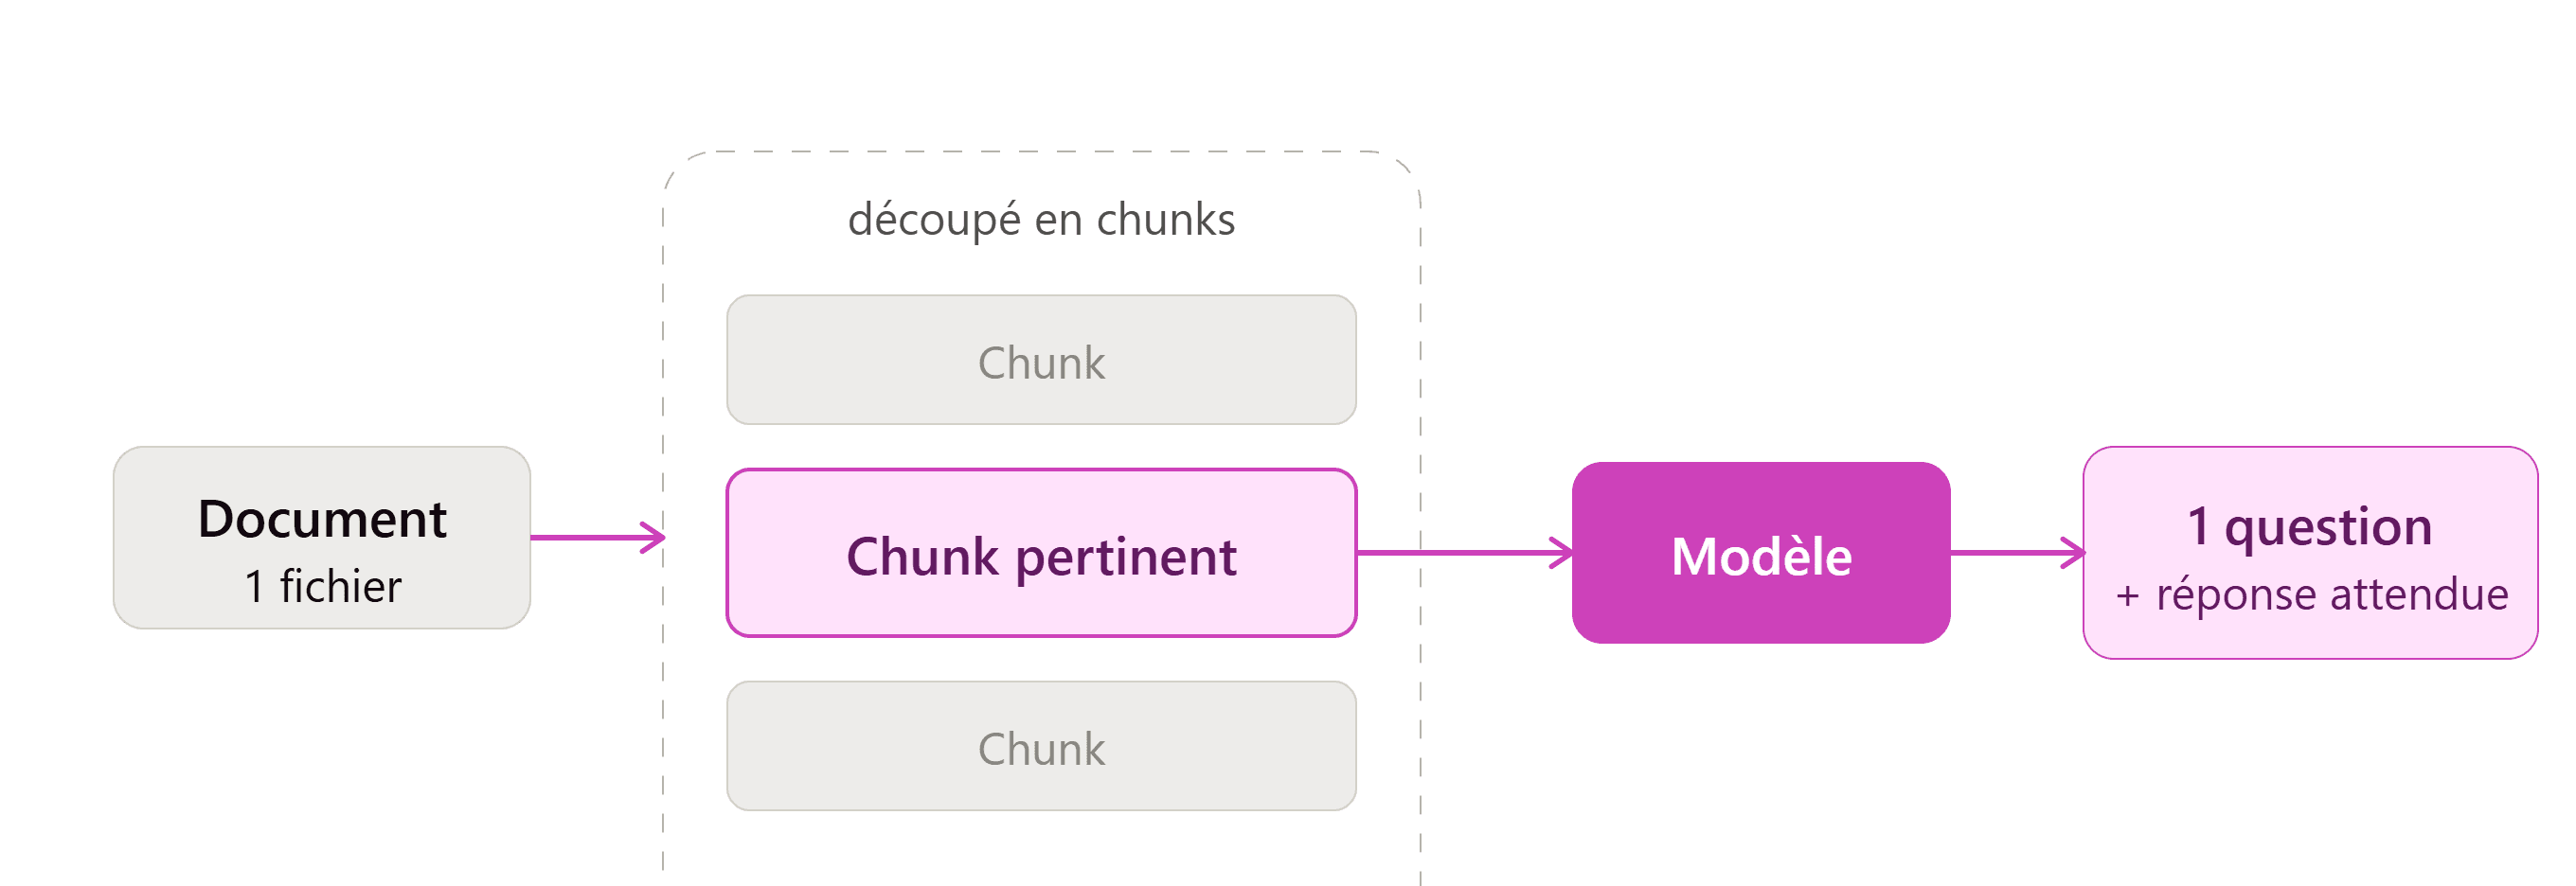 generation_questions_chunks.png
Figure 4 : Représentation du workflow de génération de questions
Nos choix d'implémentation
Concrètement, nous obtenons les meilleurs résultats avec un mix des deux approches suivantes : des questions fixes rédigées par le métier pour les cas d'usage critiques, complétées par des questions générées automatiquement.
Ensuite, pour visualiser le résultat de nos évaluations, nous sommes d'abord passés par de simples templates HTML pour analyser la sortie du LLM-as-a-Judge et visualiser l'évolution de nos métriques. C'était suffisant pour démarrer, mais nous sommes vite allés vers un outil dédié. Langfuse (nouvelle fenêtre), outil open-core, permet de relier les scores d'évaluation aux traces de l'application.
Enfin, cette même évaluation se décline en deux workflows distincts :
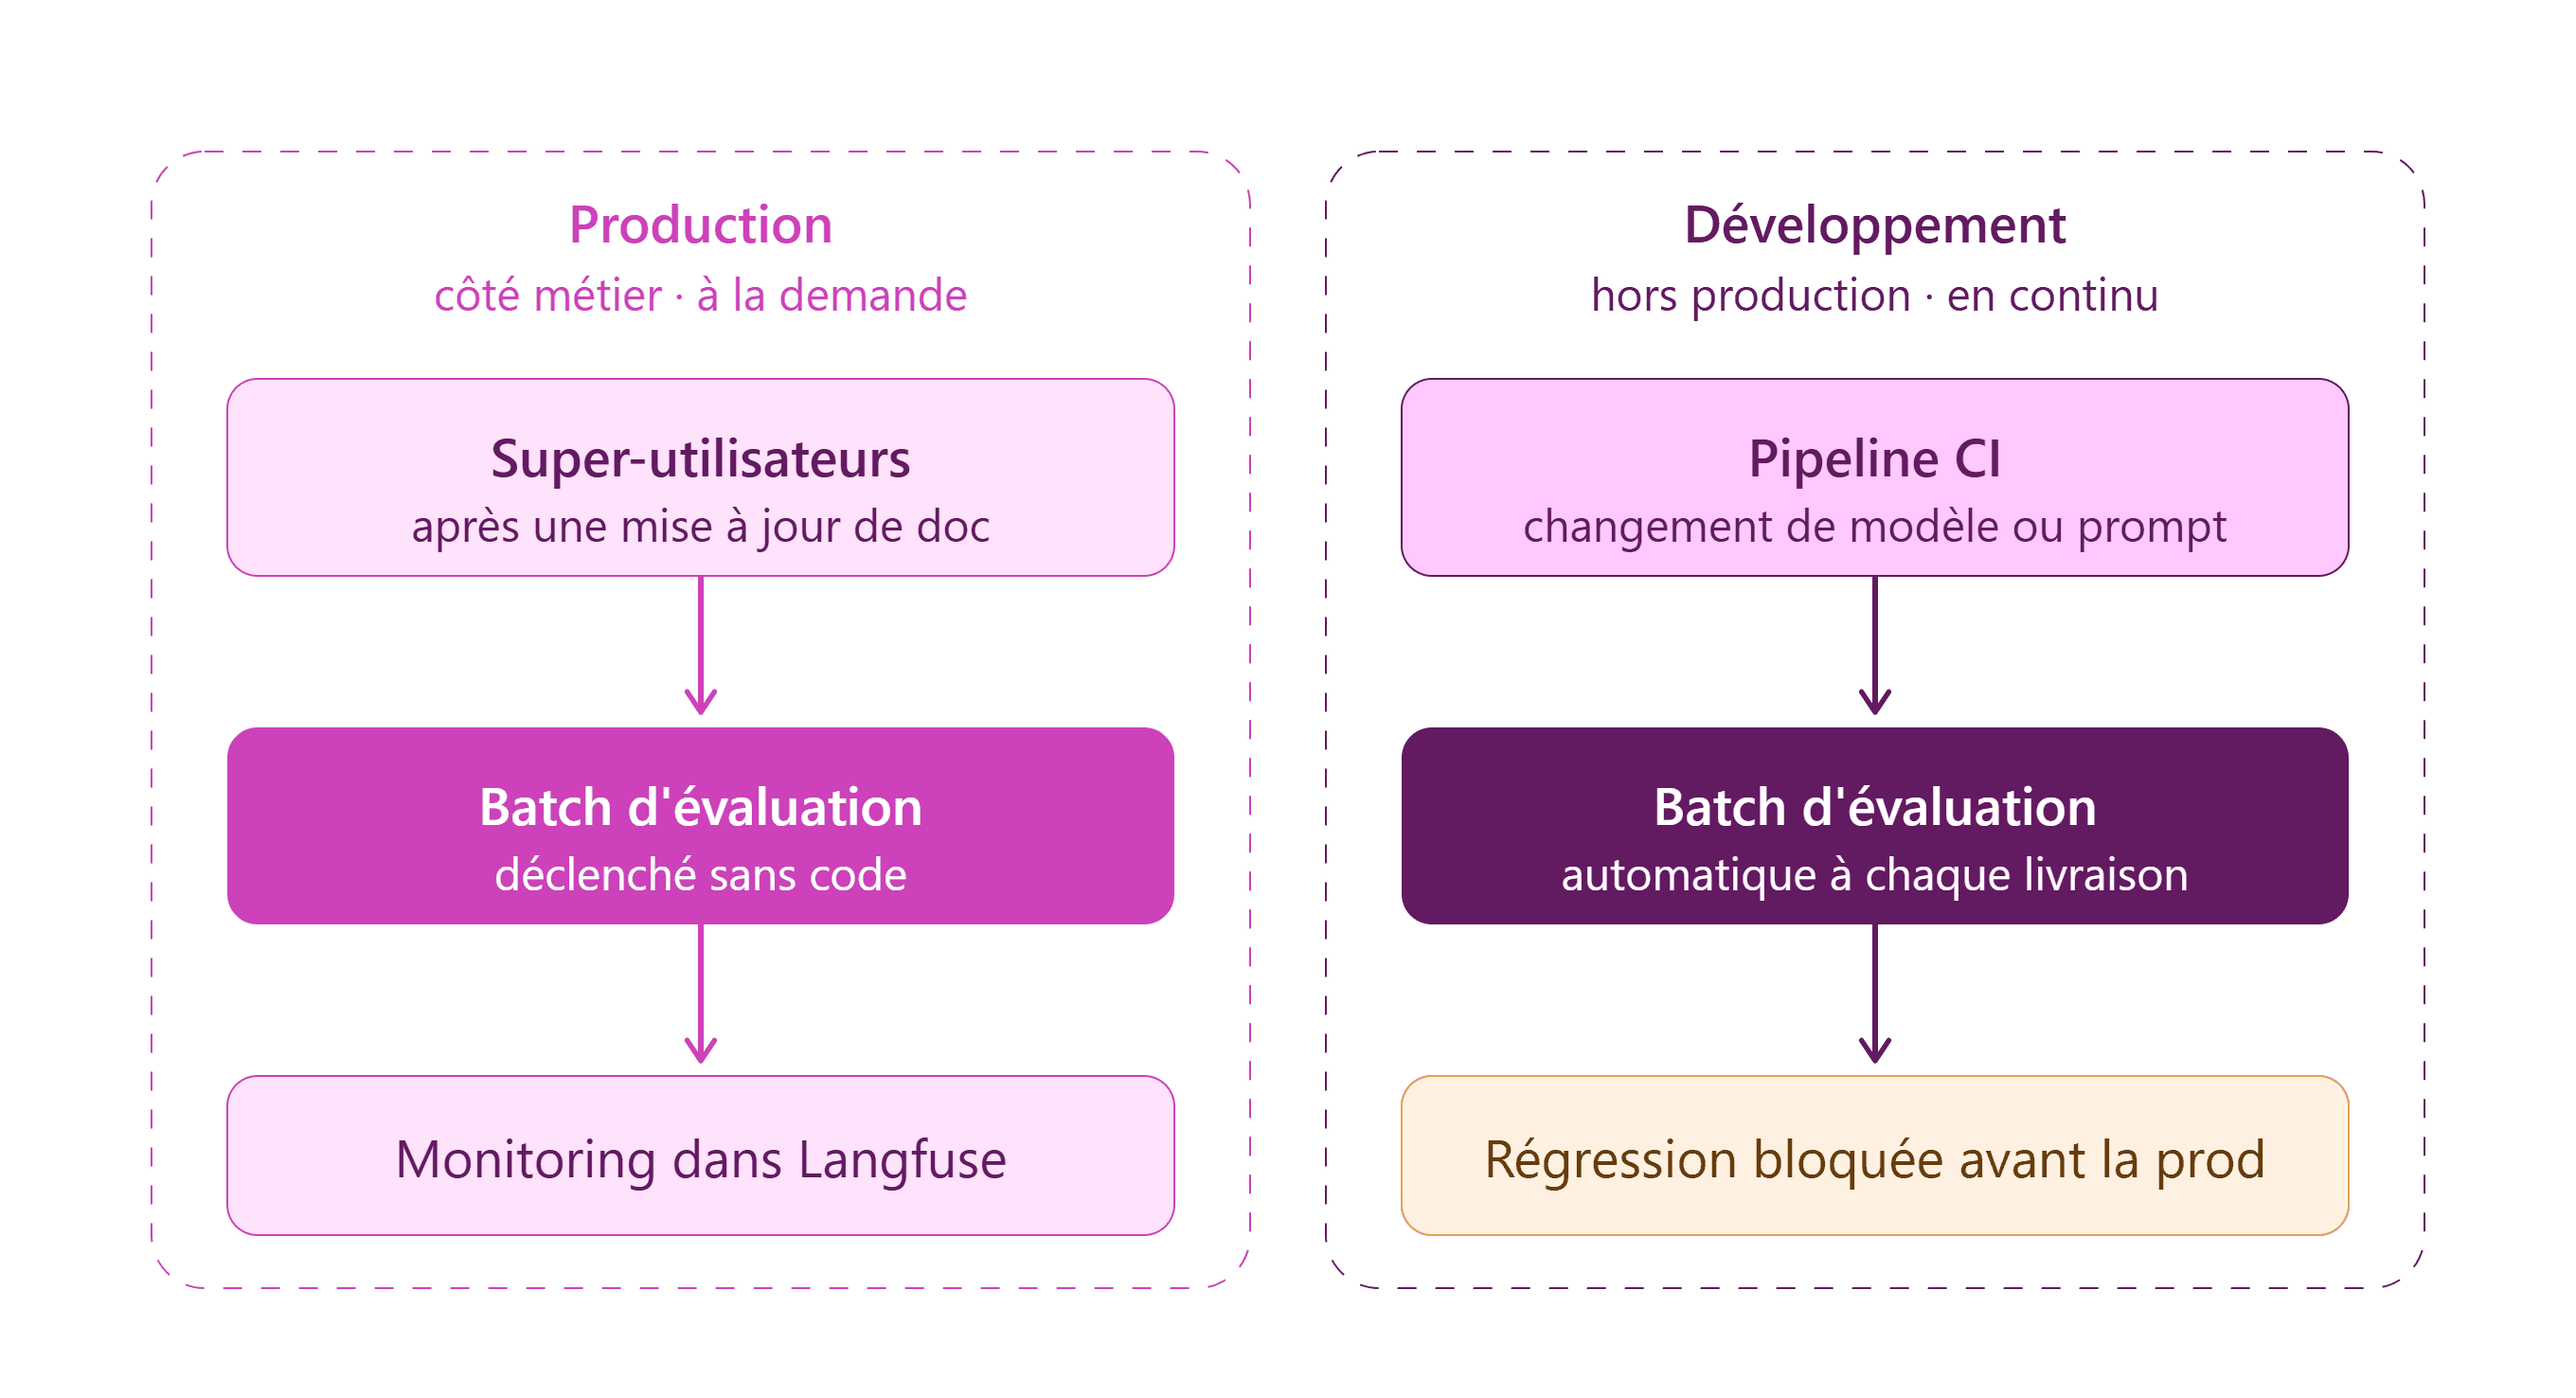
- À la demande, côté métier : les super-utilisateurs déclenchent un batch d'évaluation quand ils le souhaitent, typiquement après avoir mis à jour un document, sans aucune compétence technique nécessaire. Grâce à l'intégration Langfuse, ils sont en capacité de monitorer directement les résultats et voient l'effet de leur changement sur la qualité.
- Avant une release, côté développement. Le même batch d'évaluation tourne dans notre intégration continue, avant chaque livraison, pour détecter les régressions avant la mise en production.
Même socle de mesure, deux portes d'entrée : l'une met la qualité entre les mains du métier, l'autre l'ancre dans le cycle de livraison.
 deux_workflows_environnements.png
Figure 5 : Deux workflows d'évaluation
Métriques et monitoring en production
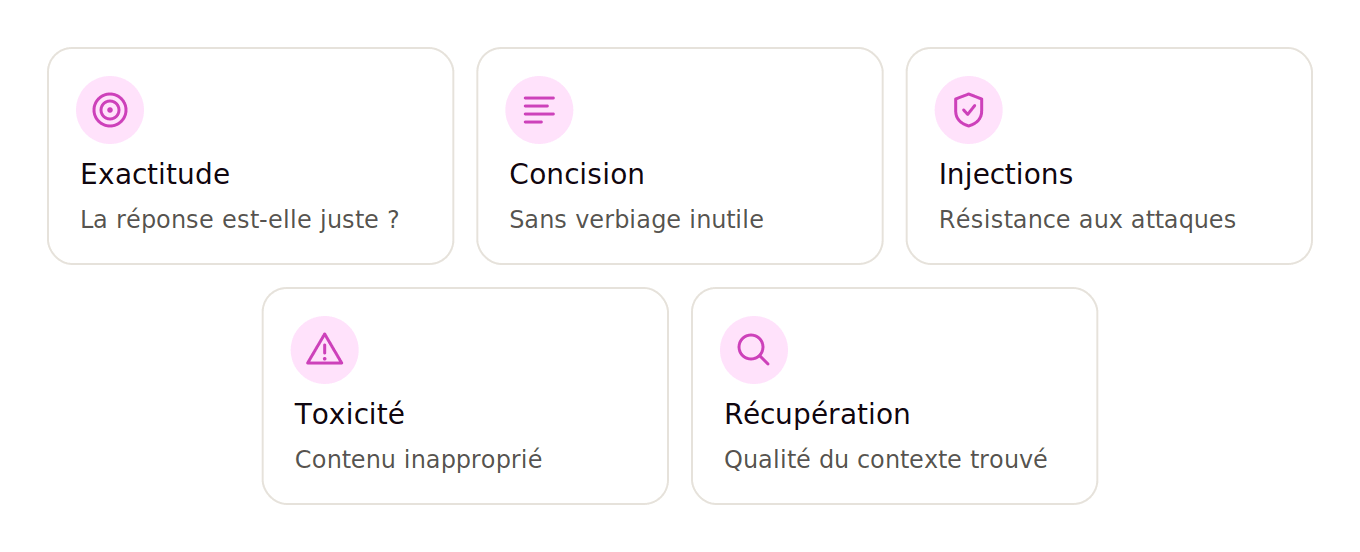
Maintenant que notre workflow est défini, rentrons sur les métriques utilisées. Notre agent est capable d'évaluer plusieurs métriques, basés sur les instructions transmises. Nous estimons qu'il est intéressant de suivre l'évolution des métriques suivants :
 metriques_cles.png
Figure 6 : Les métriques clés
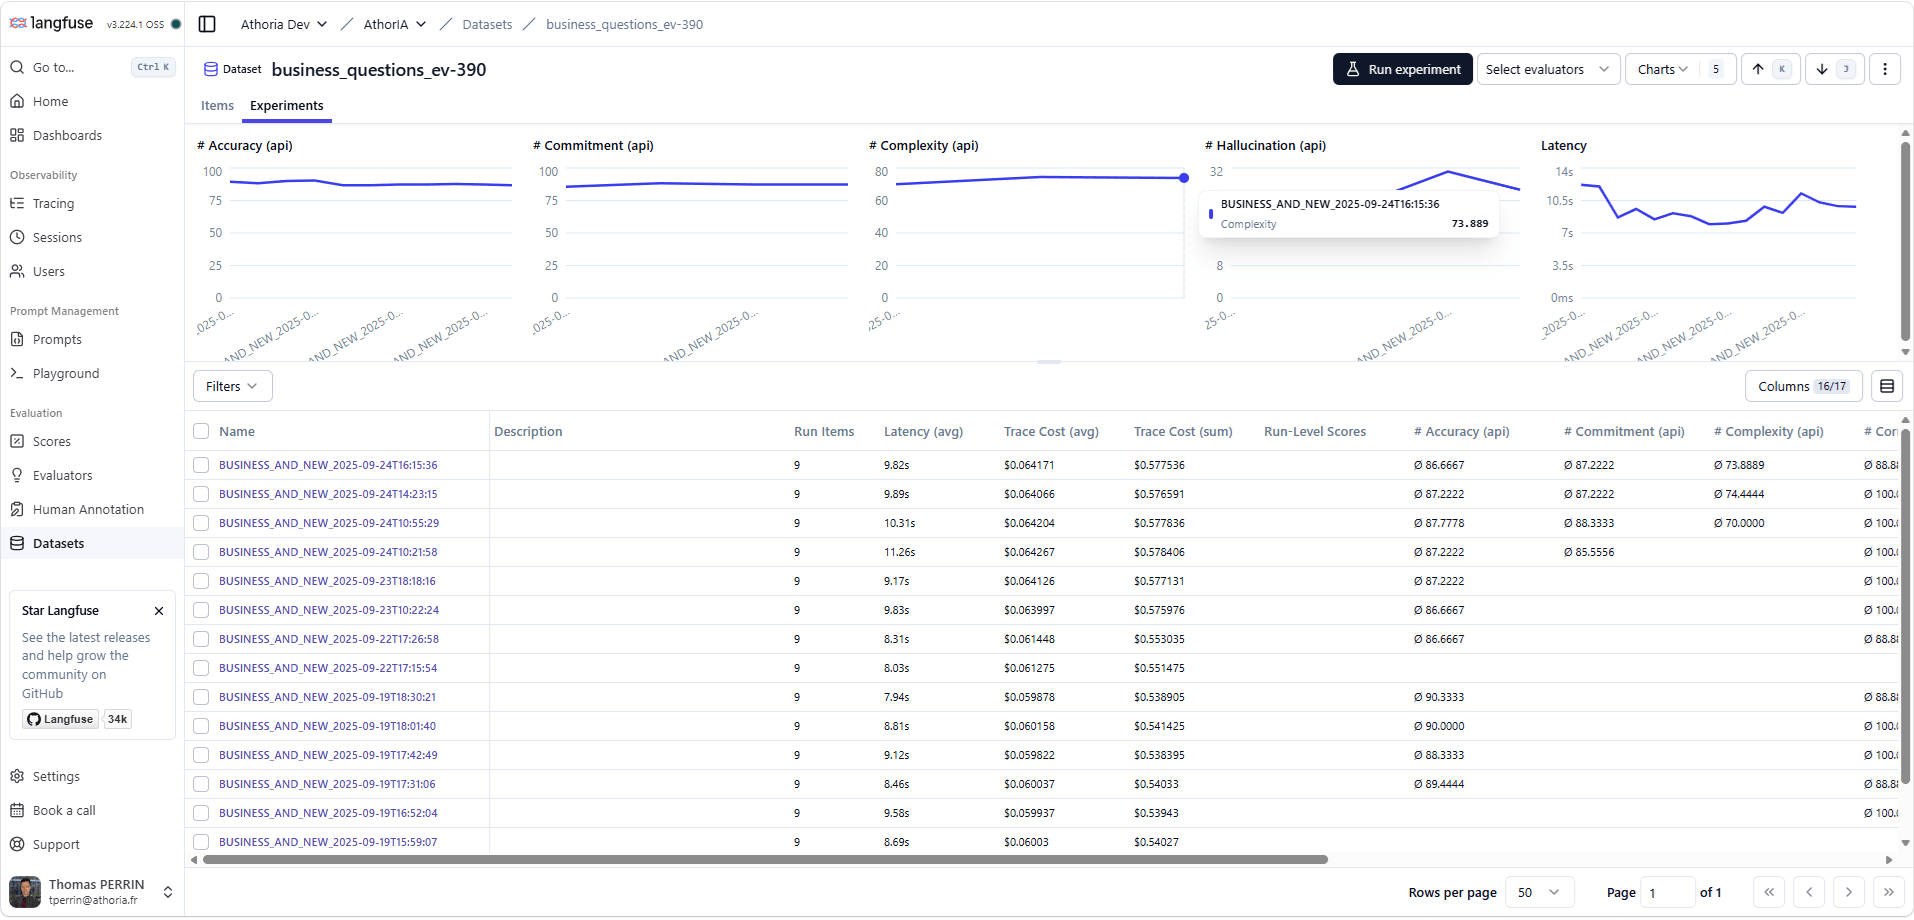
Langfuse fournit ensuite des dashboards qui donnent la visibilité complète sur chaque campagne d'évaluation : nos métriques customs, la latence, le coût, mais également la capacité de comparer une exécution à une autre.
 langfuse_dashboard.png
Figure 7 : Visualisation des campagnes d'évaluation sur Langfuse
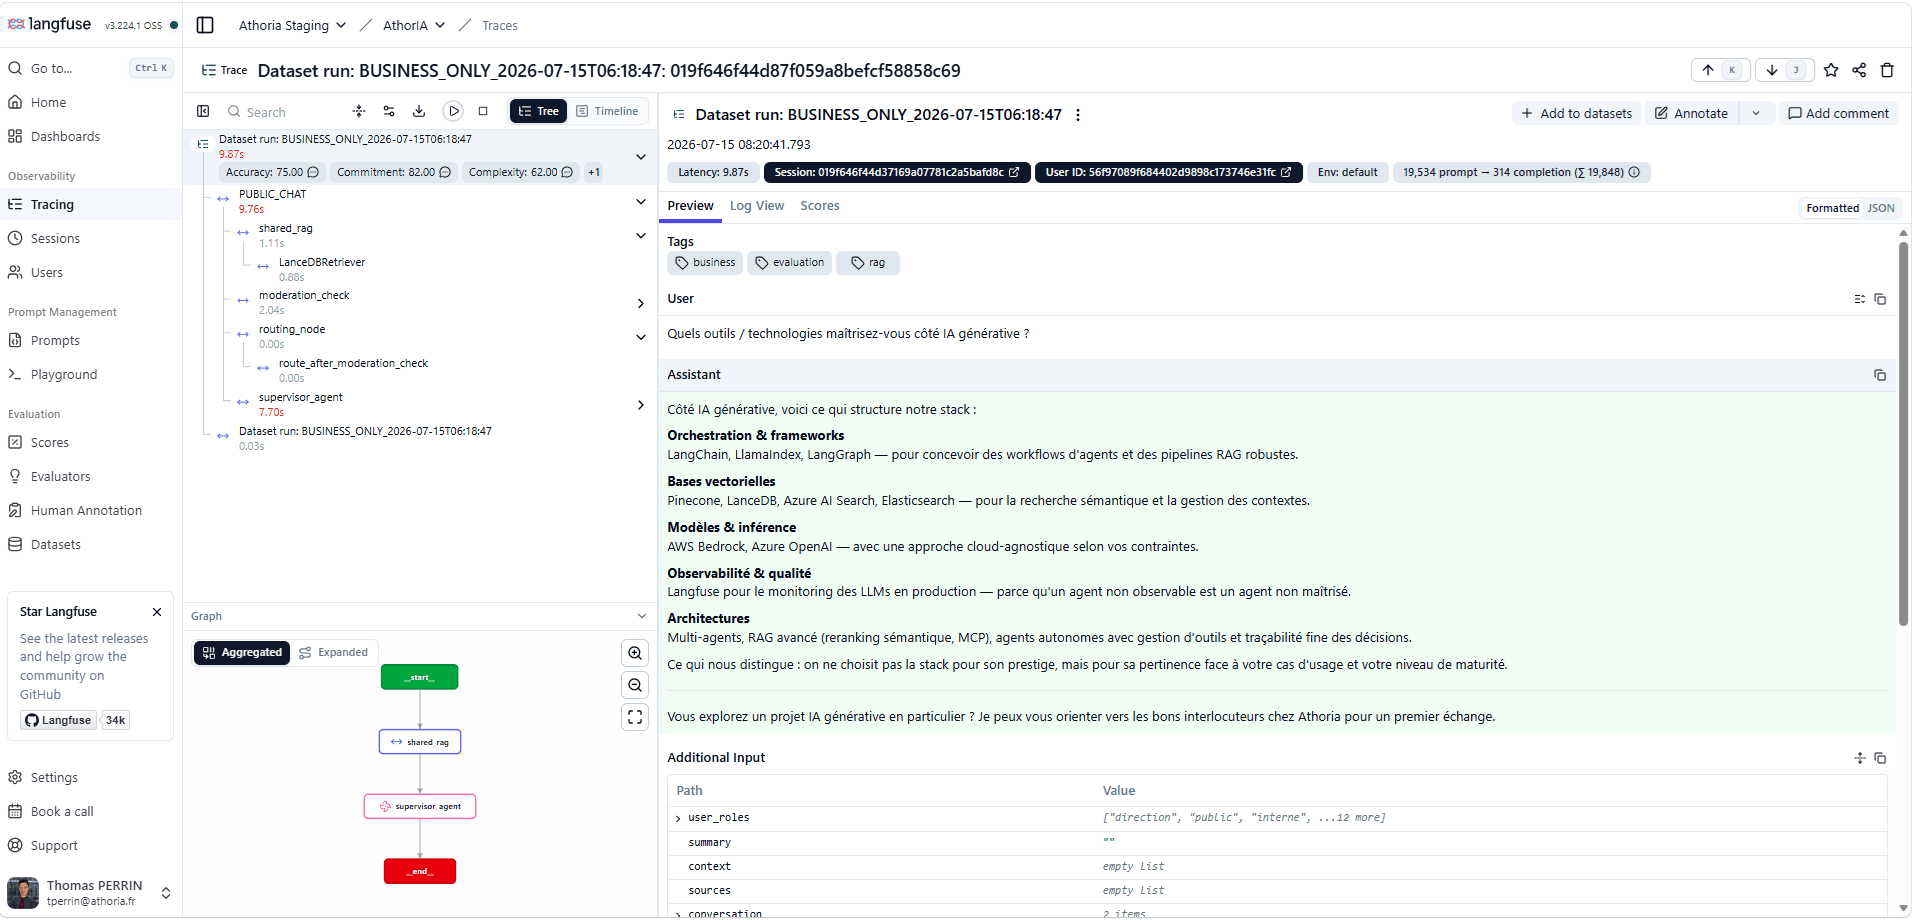
Cette visibilité est utile également en production pour récupérer le contenu d'une trace lorsqu'un utilisateur remonte un problème. Cette démarche s'inscrit dans une volonté d'amélioration continue de la pertinence de nos agents : que cela soit dans l'orchestration ou bien dans la manière dont le contexte est construit.
 langfuse_trace.png
Figure 8 : Visualisation d'une trace sur Langfuse
Pour aller plus loin
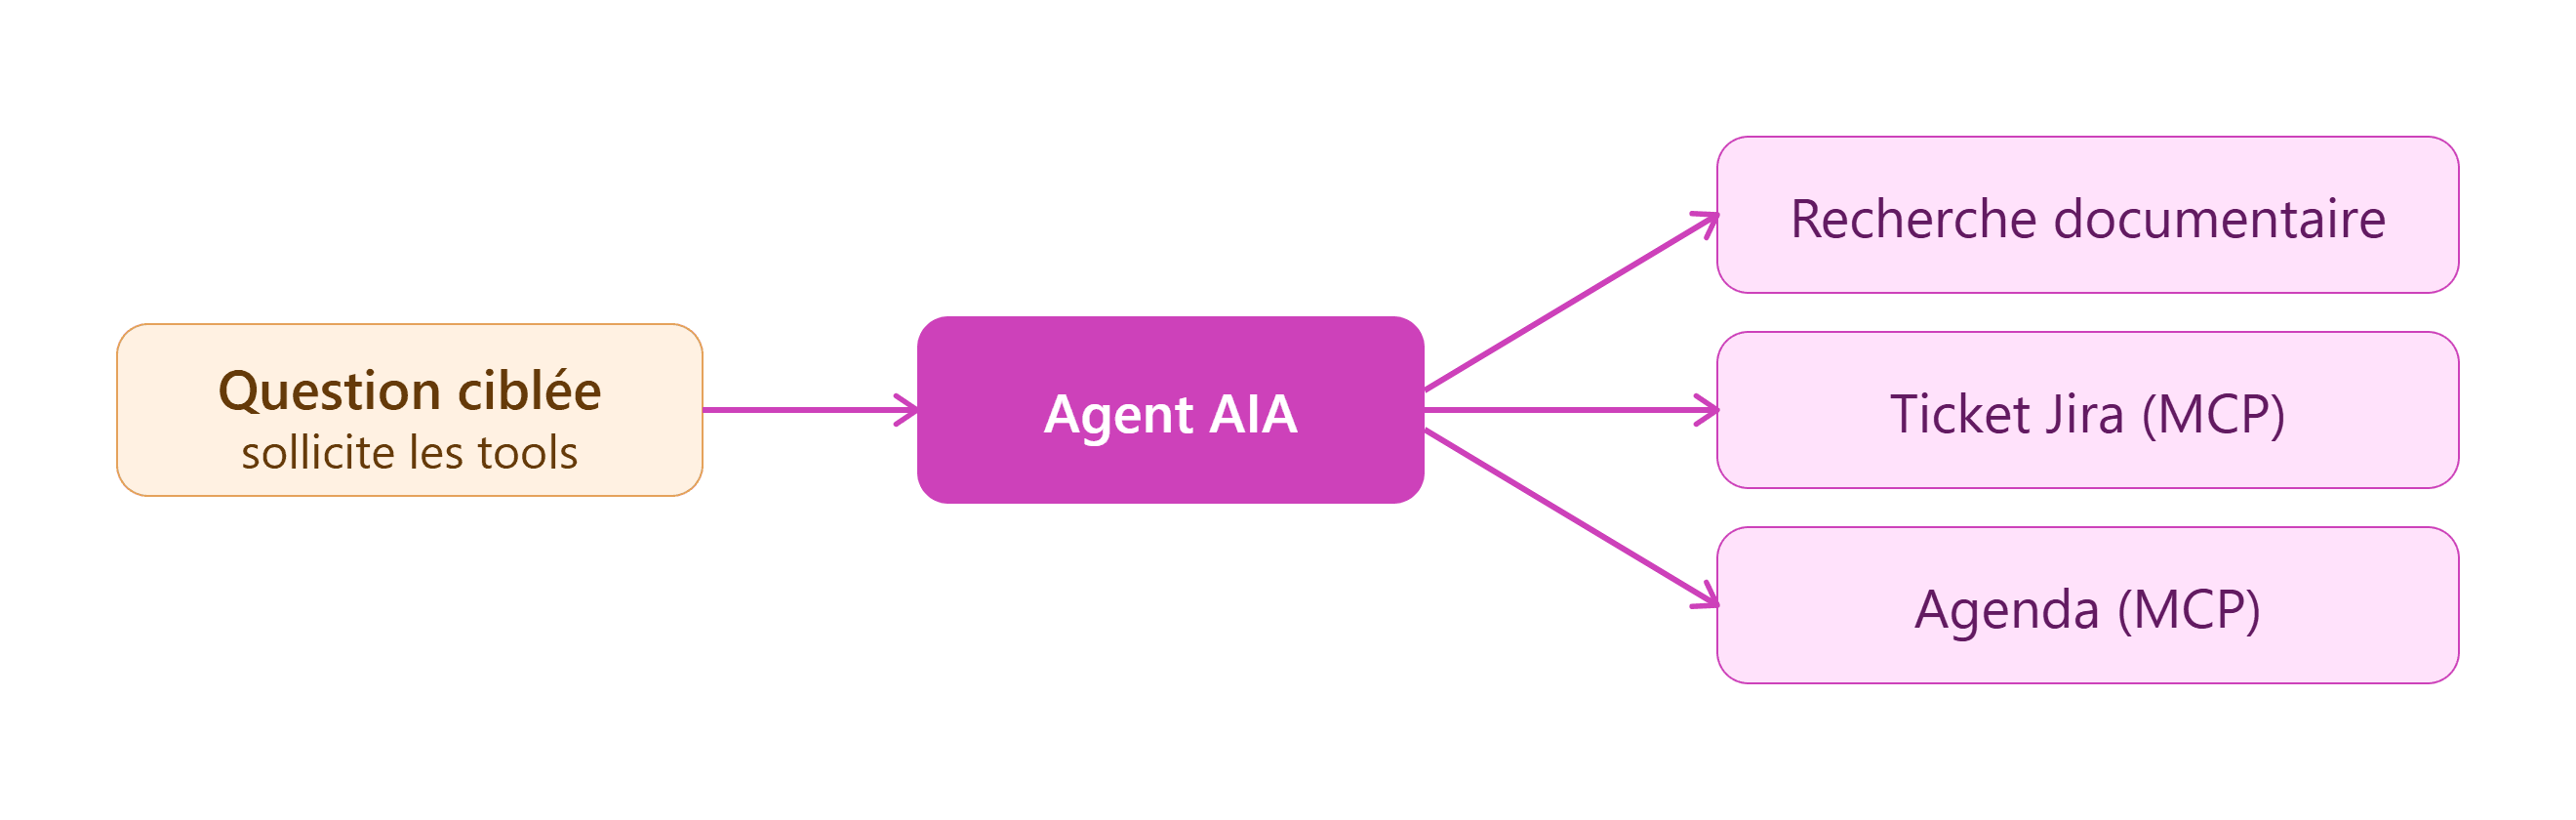
Si votre agent sait appeler des tools (via un server MCP, par exemple), ces capacités doivent elles aussi être évaluées. Changer la description d'un tool, l'architecture de l'assistant ou le modèle sous-jacent peut modifier la façon dont l'agent appelle ses tools. Il faut donc des questions qui incitent l'agent à solliciter chacun d'eux : rédigées par le métier, un QA ou même générées automatiquement si vos serveurs MCP sont trop vastes pour une couverture manuelle.
 evaluation_tools_mcp.png
Figure 9 : Evaluation de l'exécution des tools
La règle que nous gardons en tête : chaque capacité donnée à l'agent doit être évaluée. Et toutes ces mesures alimentent ensuite une logique d'alerting sur détection de régression, intégrée à nos campagnes de test dans Xray for Jira (nouvelle fenêtre) afin de conserver une approche QA unifiée.
Conclusion
Fiabiliser un service d'IA générative en production est un défi autant technique qu'organisationnel. Notre expérience sur AIA nous a appris une chose avant tout : il faut installer les mécanismes de mesure et d'évaluation dès le début du projet, sans attendre l'incident. L'automatisation via le LLM-as-a-Judge et la génération de questions permet de tenir un niveau de qualité élevé tout en réduisant la charge manuelle. Mais le vrai enseignement est humain. Notre meilleur atout, ce sont les super-utilisateurs : proches du métier, propriétaires de la base documentaire, ils sont les mieux placés pour nourrir le jeu d'évaluation en questions réellement pertinentes. La clé du succès tient dans cet équilibre entre automatisation intelligente et contrôle humain. C'est lui qui permet de profiter de la puissance de l'IA générative sans renoncer à la confiance qu'exigent les applications critiques.
Contactez-nous (nouvelle fenêtre) pour un accompagnement personnalisé sur ce sujet.