Les environnements Cloud éphémères au service des tests automatisés
Avoir des environnements dédiés aux tests, c'est une norme de l'industrie. La vraie question est la suivante : avez-vous un environnement dédié aux tests automatisés ? Parce que tant qu'il ne l'est pas, il est partagé. Et un environnement partagé, c'est un environnement où n'importe qui peut, sans le vouloir, fausser vos résultats.
J'ai passé les deux dernières années à mettre en place des pipelines de tests automatisés chez des clients aux architectures très différentes : un leader de l'assurance-crédit, une plateforme de paris, une solution e-learning. À chaque fois, le même constat. Les tests sont là, les scénarios sont écrits, mais ils tournent sur un environnement où un développeur pousse un correctif à la main, où un QA rejoue un scénario manuel, où une dépendance externe évolue sans prévenir.
Le jour où votre campagne de non-régression passe au rouge, impossible de trancher : est-ce une anomalie ? Ou un test manuel qui a modifié une donnée à 3h du matin ?
C'est là qu'interviennent les environnements cloud éphémères.
Mais c'est quoi exactement, un environnement éphémère ?
La réponse tient en trois mots : infrastructure, demande, temporaire. Un environnement éphémère, c'est une infrastructure complète (bases de données, services applicatifs, mocks, configuration réseau) déployée automatiquement, à la demande, pour une durée limitée, puis détruite. Il n'existe que le temps d'accomplir sa mission : permettre à vos tests de tourner dans des conditions identiques, reproductibles et isolées du reste du monde. Quatre principes le définissent :
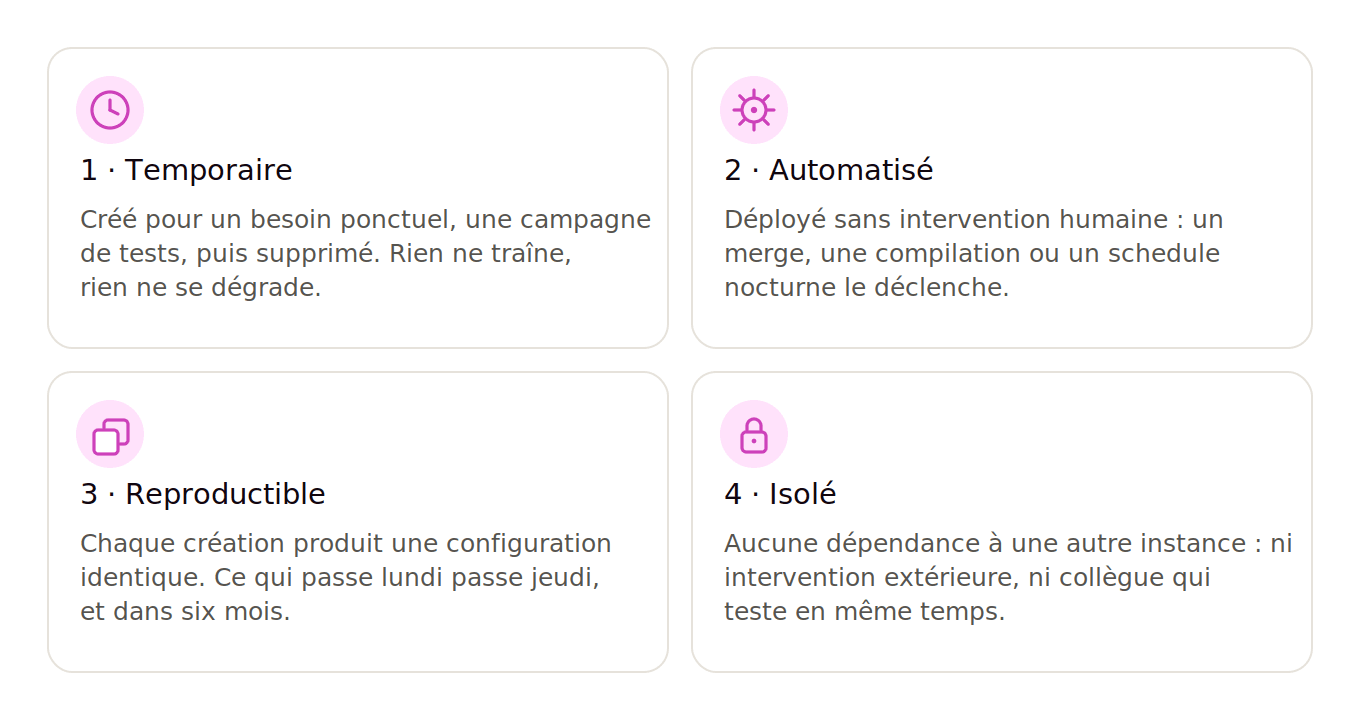 01_quatre_principes.png
Figure 1 : Les quatre principes d'un environnement éphémère.
Les briques indispensables
Avant de montrer comment ça se construit concrètement, un rapide tour des outils sur lesquels on s'appuie systématiquement. L'Infrastructure as Code d'abord, avec Terraform, CloudFormation ou Azure Resource Manager : sans IaC, pas d'environnement éphémère, c'est le fondement de tout. La CI/CD ensuite, avec GitLab CI, GitHub Actions ou Jenkins : le chef d'orchestre qui déclenche, surveille et enchaîne les étapes. La QA Automation, avec Selenium, Playwright, Postman ou des frameworks BDD type Cucumber.js avec Gherkin : les acteurs qui jouent dans l'environnement qu'on vient de monter. Et la gestion des données, avec PostgreSQL, SQL Server, mais aussi des outils comme LocalStack pour mocker les services AWS sans les payer à plein tarif.
Un cas concret : ce qu'on a vécu chez un client
Permettez-moi de sortir du théorique. Chez un leader mondial de l'assurance-crédit que j'accompagnais, voilà à quoi nous étions confrontés : une organisation en plusieurs trains SAFe, chacun responsable d'un périmètre métier différent (Commercial, Claims, Pricing, Financial, Commission), et une architecture en cours de refonte vers le cloud. Les tests existaient, mais ils s'exécutaient dans des environnements partagés, exposés à toutes les interférences possibles.
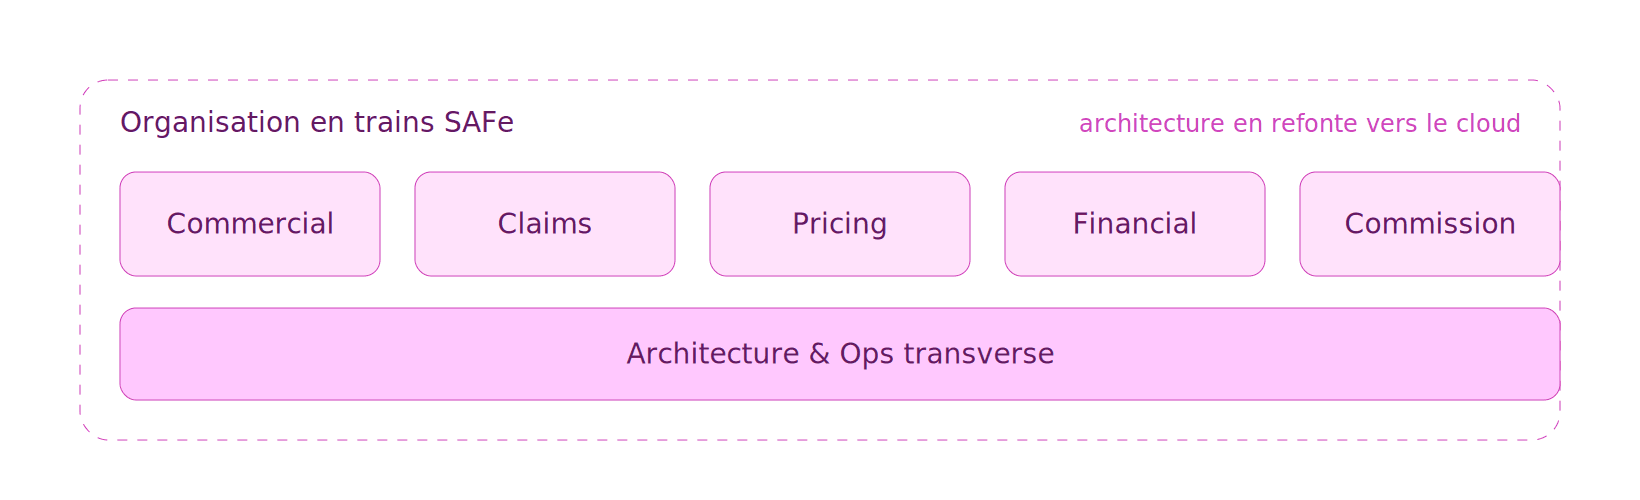 02_contexte_trains_safe.png
Figure 2 : Une organisation en trains SAFe
L'objectif qu'on s'est fixé était simple à formuler, moins simple à réaliser : obtenir une visibilité quotidienne sur les régressions potentielles de chaque programme, isoler l'environnement pour éliminer les faux positifs, et optimiser les coûts en exploitant au maximum les fonctionnalités du cloud.
Le workflow cible
La structure qu'on a mise en place se découpe en trois phases, orchestrées par la CI :
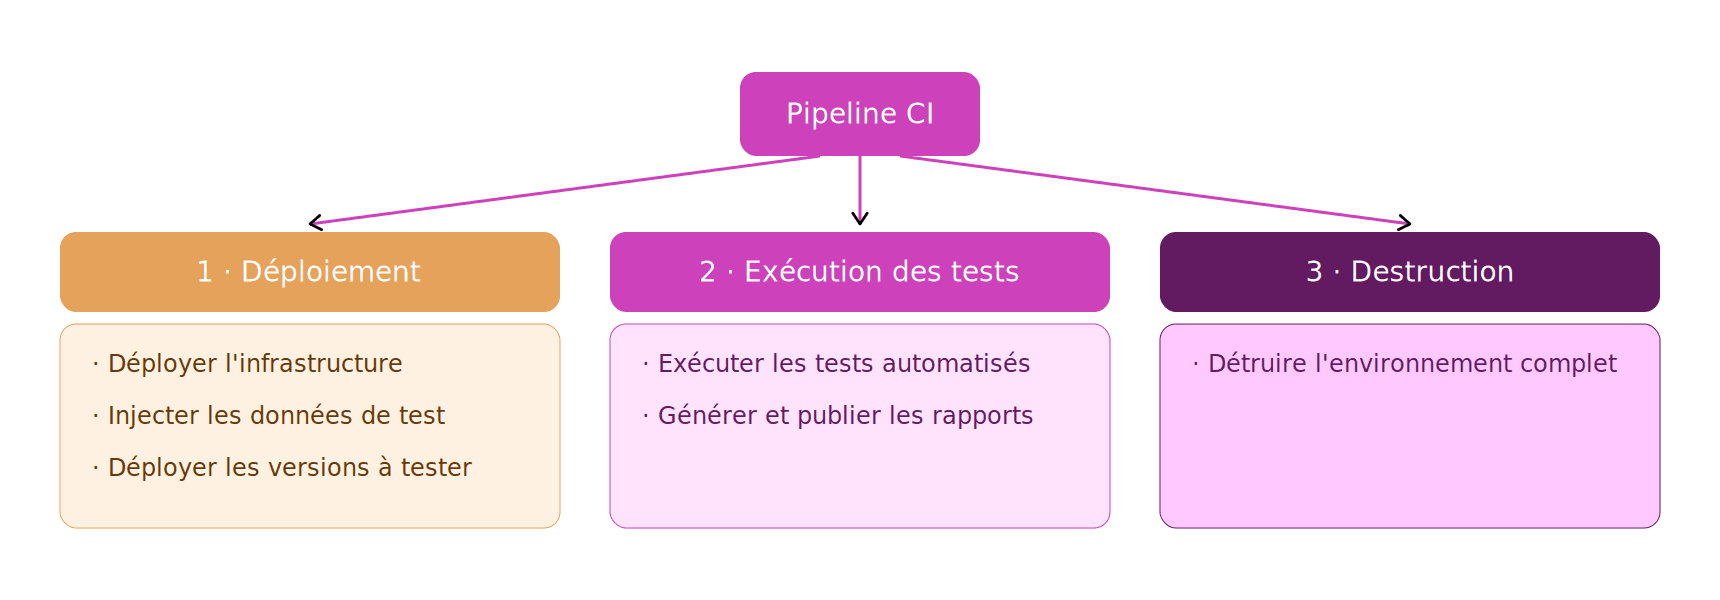 03_workflow_cible.png
Figure 3 : Le workflow cible orchestré par la CI, en trois phases
En apparence, c'est propre. En pratique, la première itération nous a ouvert les yeux.
Première itération : les coûts cachés
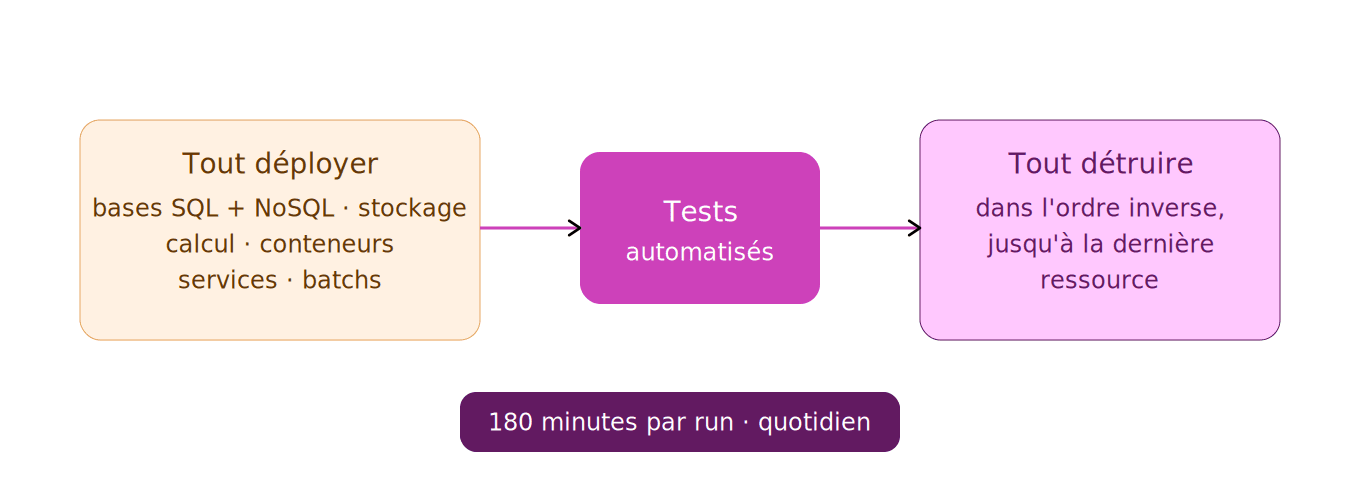
Notre première approche, c'était la construction from scratch et éphémère. On déployait tout : les bases NoSQL, le stockage partagé, les bases relationnelles (SQL Server + PostgreSQL), les instances de calcul, l'orchestrateur de conteneurs, les services applicatifs, les batchs. Après les tests, on détruisait tout dans l'ordre inverse.
 04_premiere_iteration.png
Figure 4 : La première itération recrée puis détruit toute l'infrastructure à chaque run
180 minutes d'exécution complète. Trois heures. Par run. Quotidien.
Et en analysant les coûts, on a découvert que 35 % des coûts d'infrastructure provenaient uniquement des bases de données managées, que les runners CI eux-mêmes représentaient une part significative de la facture, et que les dépendances entre les trains SAFe créaient des délais en cascade. C'était trop long, trop cher, et les trains se bloquaient les uns les autres. Il fallait revoir la copie.
Deuxième itération : se concentrer sur ce qui coûte cher
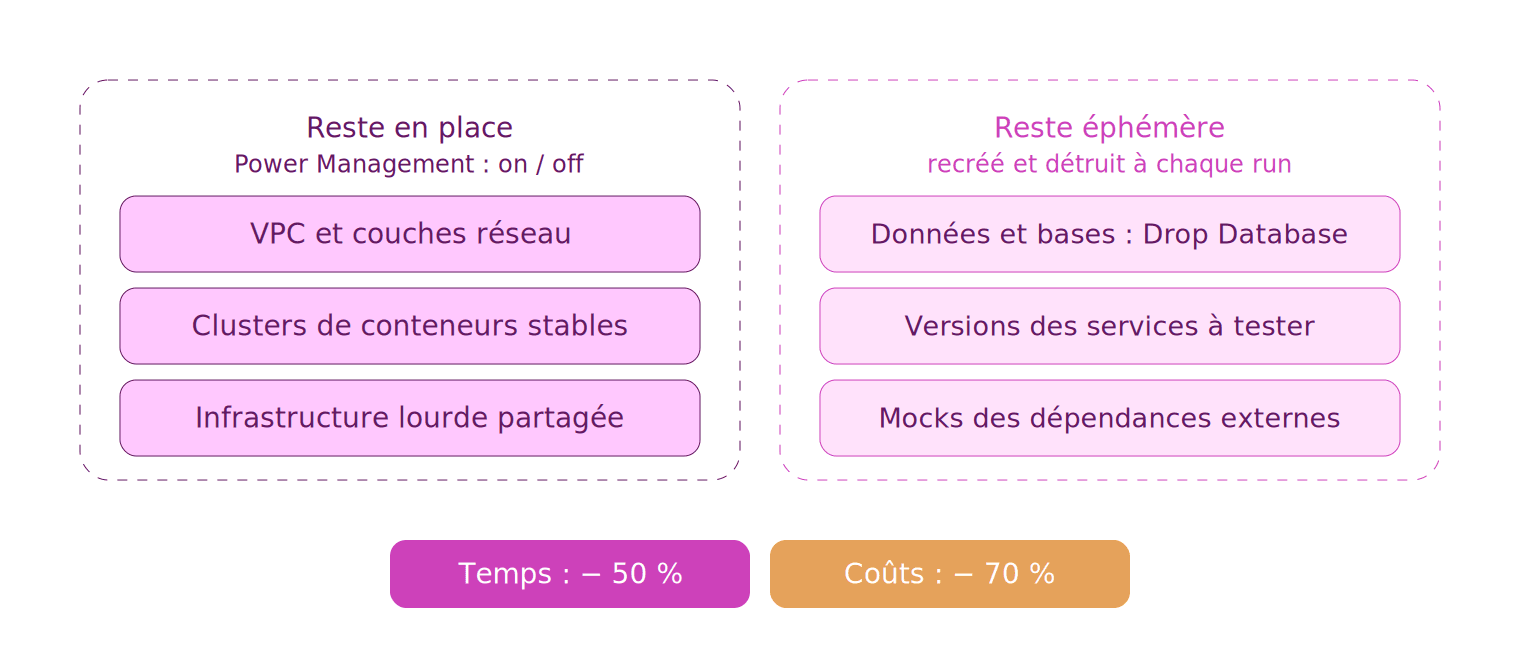
La leçon de la première itération est claire : ne pas tout reconstruire si ce n'est pas nécessaire. On a changé de stratégie sur deux points. D'abord, on a arrêté de recréer intégralement l'infrastructure lourde à chaque run : les ressources qui survivent d'une exécution à l'autre (les VPC, les clusters de conteneurs stables, certaines couches réseau) restent en place, pilotées par une stratégie de Power Management qui démarre ce qui doit tourner puis l'arrête après. Ensuite, on a mocké les services majeurs : plutôt que de dépendre des vraies instances de bases de données sur toute la durée du cycle, on alimente le minimum nécessaire et on détruit les bases en fin de run, avec un Drop Database plutôt qu'un Destroy Instances.
 05_deuxieme_iteration.png
Figure 5 : La deuxième itération sépare le socle qui reste en place de ce qui reste éphémère
Le résultat de la deuxième itération :
| Métrique | Avant | Après |
|---|---|---|
| Temps d'exécution | 180 min | 90 min (− 50 %) |
| Coûts d'infrastructure | référence | − 70 % |
90 minutes. On divise par deux le temps, par trois les coûts. Et les tests sont toujours aussi fiables.
La stratégie de mocks : l'arme secrète de l'isolation
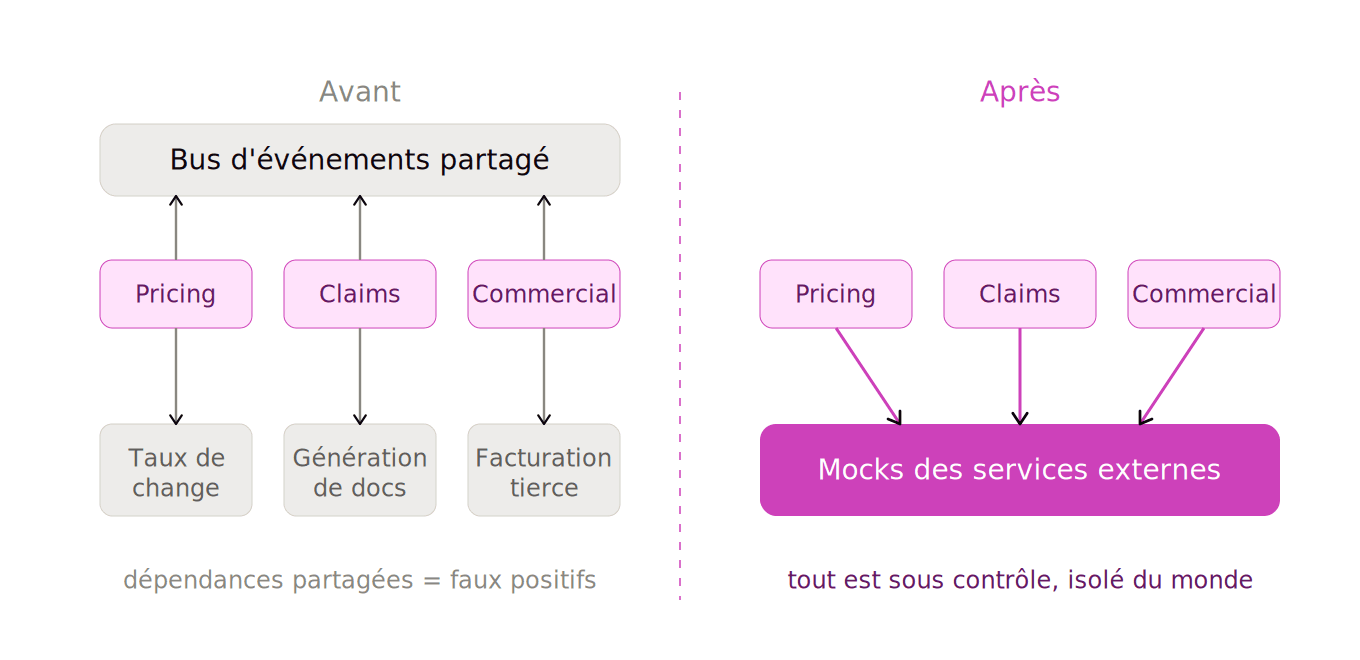
L'isolation, ce n'est pas qu'une question de VPC ou de namespaces. C'est aussi, et surtout, une question de mocks. Dans notre cas, l'architecture cliente comportait des dizaines de services externes : flux d'événements, API KYC, systèmes de facturation, taux de change, génération de documents. Chacun de ces services, s'il est partagé avec d'autres environnements ou s'il dépend d'un tiers, est une source potentielle de faux positifs. Notre réponse : mocker tous les services extérieurs.
 06_strategie_mocks.png
Figure 6 : Avant et après la mise en place de mocks
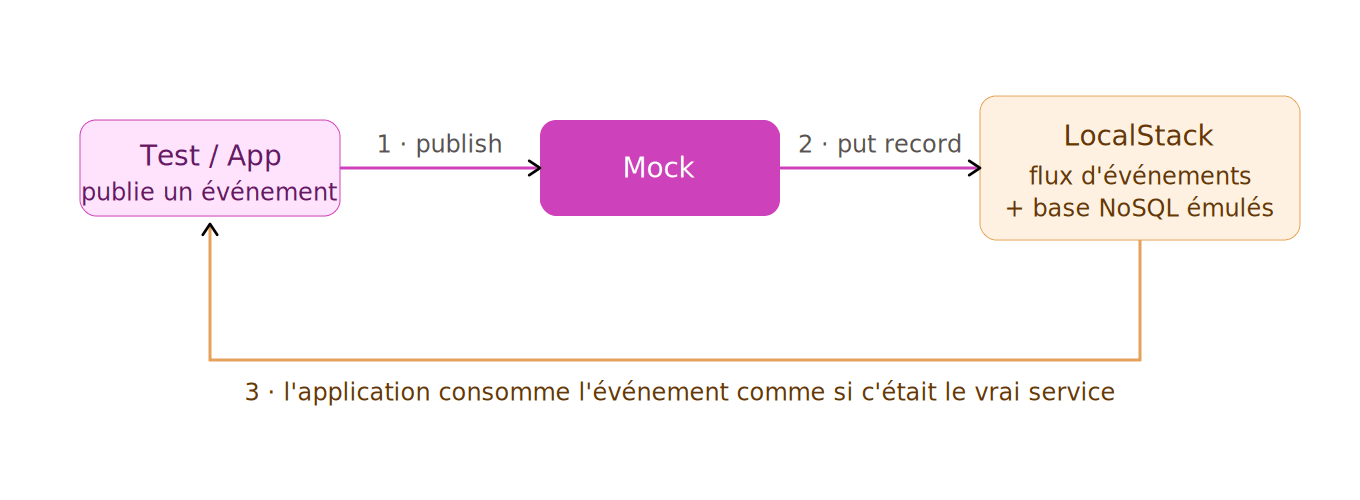
Pour les flux d'événements notamment, on a utilisé LocalStack (nouvelle fenêtre), qui émule les services AWS en local. Le principe :
 07_flux_localstack.png
Figure 7 : Le flux de mock des événements via LocalStack
Résultat : on teste le comportement réel de l'application, sans payer pour des streams actifs 24h/24, et sans risquer de polluer un environnement partagé. Mocker n'est pas tricher, j'y reviendrai.
La gestion des données : le nerf de la guerre
C'est souvent là que les projets de tests automatisés échouent. Pas sur les outils, pas sur l'infrastructure. Sur les données. Chez notre client, l'infrastructure de données en jeu donnait le vertige : 2 bases SQL Server, 6 bases PostgreSQL, 8 flux d'événements, plusieurs systèmes de fichiers partagés, des buckets de stockage. Pour gérer tout ça proprement, on a posé trois règles fermes :
- Analyse d'impacts avant tout. Chaque test doit être indépendant. Si le test A modifie un état que le test B lit, vous avez un problème : cartographiez ces dépendances avant même d'écrire la première ligne de scénario.
- Un seul déploiement des données référentielles. Les référentiels produits et les configurations de base sont déployés une seule fois au démarrage, depuis des snapshots de production anonymisés. Pas à chaque test.
- Ownership des données créées. Chaque test est responsable de ses propres données : ce qu'il crée, il le nettoie. L'environnement reste dans un état propre pour le test suivant.
Le design de chaque test
Un test dans ce système suit toujours la même structure, en cinq temps :
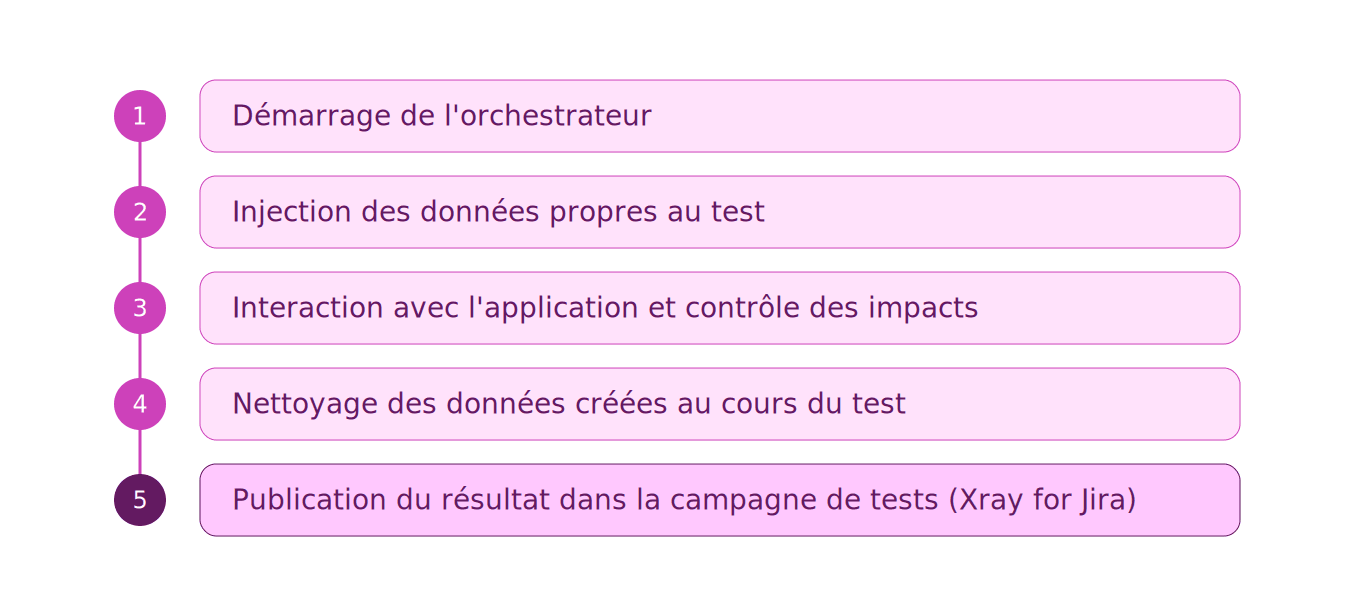 09_design_test_5_temps.png
Figure 8 : Les cinq étapes d'un test
Ce pattern garantit qu'un test n'interfère jamais avec un autre, même s'ils tournent en parallèle sur le même environnement.
Et le ROI dans tout ça ?
Je vous entends déjà : « C'est bien beau, mais ça coûte quoi à mettre en place ? » Voilà les hypothèses qu'on a posées avec le client pour construire notre projection : une équipe de 3 automaticiens et 2,5 testeurs manuels ; 4 heures pour le design d'un cas de test et 15 heures pour son automatisation ; un coût de 2 jours-homme par anomalie détectée en production, contre 0,5 jour-homme quand elle est détectée en UAT. Sur cette base :
| Année | % d'automatisation | Réduction des anomalies | ROI |
|---|---|---|---|
| 2024 | 30 % | − 15 % | 13 % |
| 2025 | 60 % | − 30 % | 139 % |
| 2026 | 80 % | − 40 % | 302 % |
En d'autres termes : l'investissement se rentabilise dès la première année, et à horizon trois ans, vous avez multiplié par trois votre mise de départ. Et ça, c'est uniquement sur les anomalies mesurables ; les bénéfices sur le time-to-market, la vélocité des équipes et les pénalités contractuelles évitées ne sont pas comptés.
Ce que j'aurais voulu savoir avant de commencer
Si vous vous lancez dans ce chantier, voilà les leçons que j'aurais aimé avoir dès le départ.
Ne reconstituez pas tout from scratch si vous n'en avez pas besoin. La première itération, c'est souvent l'itération « puriste » : on veut un environnement parfaitement vierge. C'est légitime, mais ça a un coût. Trouvez l'équilibre. Qu'est-ce qui doit vraiment repartir de zéro à chaque run ? Les données, oui. Les services applicatifs, souvent. L'infrastructure réseau de base, pas nécessairement.
Mocker n'est pas tricher. Certains développeurs résistent à l'idée de mocker des services « importants » comme les flux d'événements. Mais un test qui dépend d'un service externe partagé n'est pas un test fiable, c'est un pari. Le mock vous donne le contrôle.
Les données sont votre vrai sujet. Passez autant de temps sur la stratégie de données que sur l'infrastructure. L'ownership des données créées, la distinction entre données référentielles et transactionnelles, l'anonymisation des snapshots de production : tout cela conditionne la fiabilité de vos tests bien plus que le choix de votre outil d'IaC.
Itérez. La première itération ne sera pas la bonne. La deuxième non plus, complètement. C'est normal. Ce qui compte, c'est de mesurer (temps d'exécution, coûts, taux de faux positifs) et d'ajuster.
En conclusion
Les environnements cloud éphémères ne sont pas une nouveauté technologique : l'Infrastructure as Code existe depuis plus de dix ans. Ce qui est nouveau, c'est la combinaison de ces outils dans une logique de tests automatisés, et la maturité qu'ont atteinte les équipes DevOps pour les orchestrer de manière fiable.
Si vos tests échouent de manière aléatoire, si vous passez du temps à investiguer des flaky tests qui se révèlent être des problèmes d'environnement, si vos développeurs attendent qu'un environnement partagé se libère, ce n'est pas un problème de tests. C'est un problème d'infrastructure de tests. Et celui-là, les environnements éphémères le résolvent.